
MagicFrog 在桌面应用与 web 应用上都支持语音输入与语音回复。语音链路从不离开你的基础设施:识别与合成在设备上、或在你配置的自托管端点上运行,不经过任何第三方语音云。
语音输入(听写)
听写捕获你的麦克风,并把它变成 composer 里的文字。
- 两种捕获模式。
hold一直录音直到你停止;endpoint在页面测得的静音间隙(约 1.2 秒)之后自动结束一句话。 - **你自己的识别器。**音频发送到说 OpenAI-audio 请求形状的自部署转写端点——whisper.cpp server、faster-whisper、LocalAI 等本地服务器开箱即用。默认端点是 loopback(
http://127.0.0.1:8080)。 - **语言与模型提示。**可以设置主语言子标签(例如
zh或en);省略模型则让端点用自己的默认值。 - **可取消。**请求有超时上限,卡死的端点挂不住输入框。
浏览器自带的云识别不受支持——它会把音频发给浏览器厂商的云。
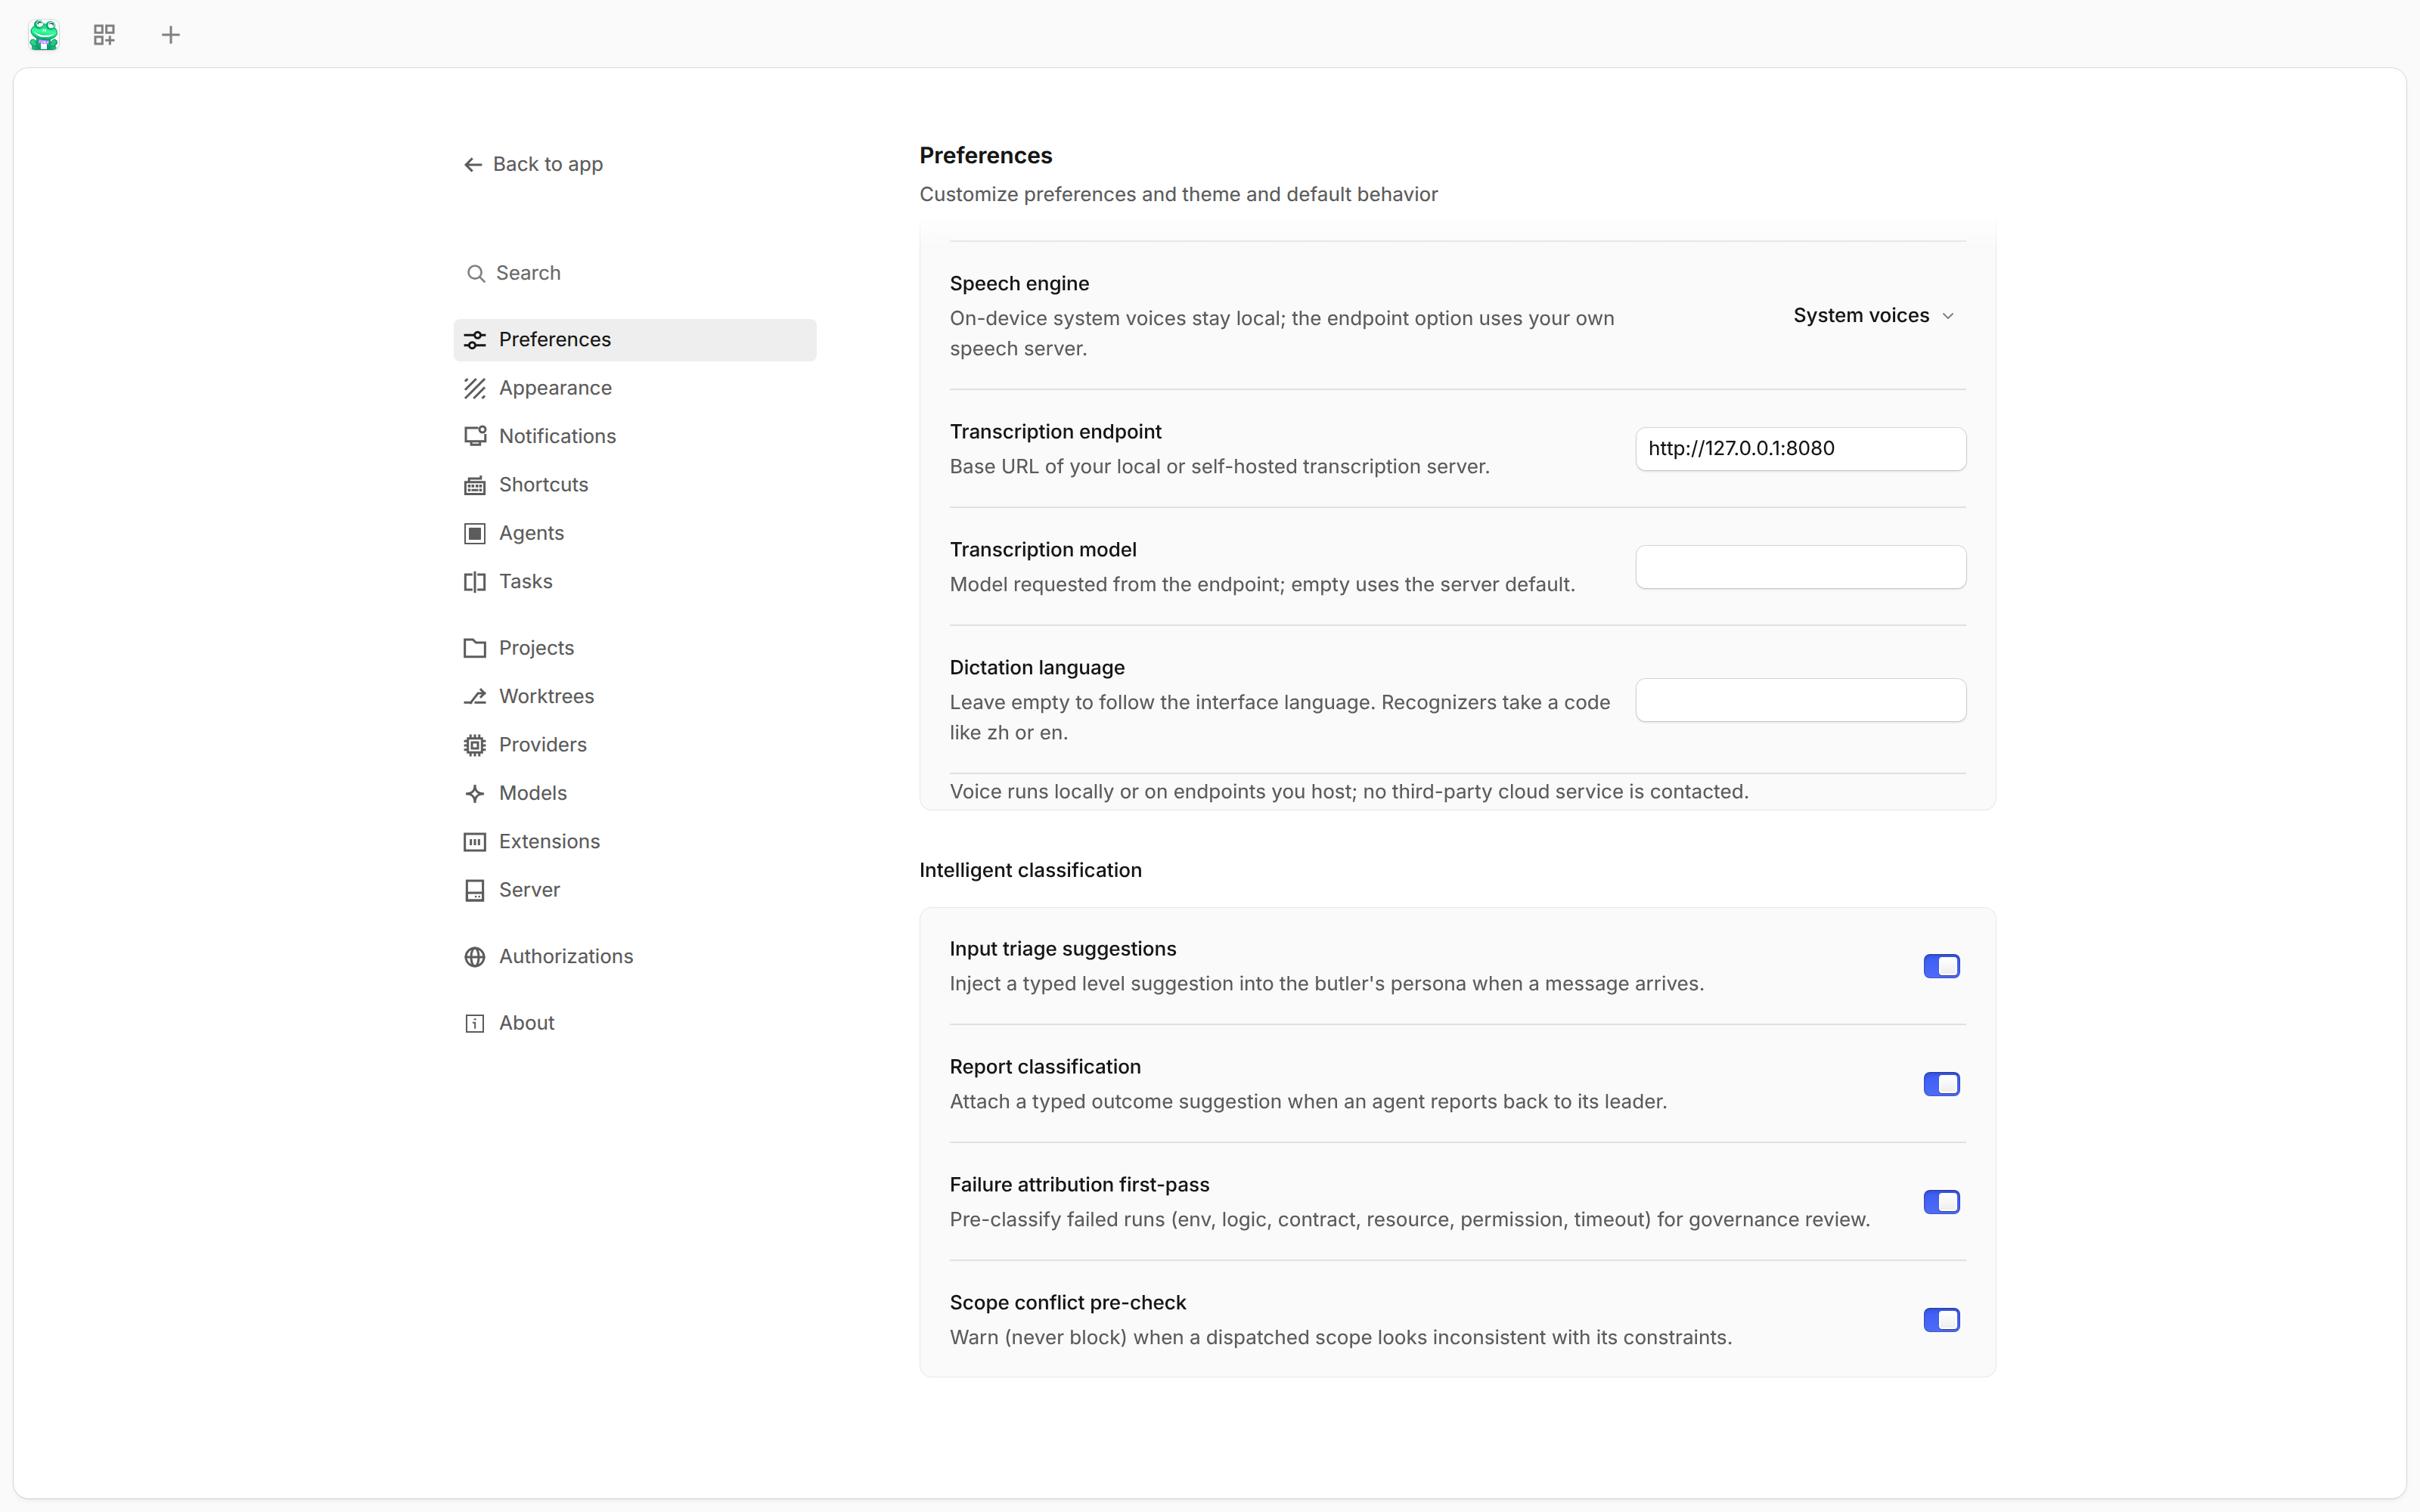
图为网页端 Settings → Preferences 页面的真实 Voice 分区:语音引擎选择、转写端点与听写语言设置。
语音回复(text-to-speech)
agent 回复可以被读出来,有全局开关与按会话覆盖(按会话记录的值胜过全局值)。
两个合成引擎,都在同一边界之内:
- 系统语音——设备自带的本地语音。
- 自部署端点——你自己运行的合成服务,同样说 OpenAI-audio 形状(默认 loopback
http://127.0.0.1:8000)。
长回复分块朗读,播放因此快速开始;字幕显示正在读的内容;每条消息至多播报一次——流式更新或恢复标签页都不会导致重复朗读。
桌面与 web
同一功能在桌面与浏览器里都可用:
| 能力 | 桌面(Electron) | Web(浏览器) |
|---|---|---|
| 麦克风捕获 | 是 | 是 |
| 系统语音播放 | 是 | 是 |
loopback http:// 端点 |
允许 | http:// 源上允许;https:// 页面上提前拒绝(混合内容) |
网页端会提前检查:在安全页面上于你录音之前就拒绝 http loopback 端点,而不是录到一半才失败。
免提对话
语音会话是一段连续对话:听、想、说三态切换,带静音控件与滚动更新的对话记录。
播放回复期间麦克风保持关闭,结束后约 0.6 秒才重新打开——助手永远不会听见它自己。
隐私边界
语音链路里没有任何地方指向第三方语音云。引擎只允许触达你自己的 loopback 或自托管端点以及设备上的语音栈。
语音设置按应用安装本地持久化:听写语言、两个端点与模型、合成引擎、全局朗读回复开关,以及按会话覆盖。